De l’IAM à l’ANS : comment le DNS veut sécuriser l’ère des agents autonomes ?
Les agents IA autonomes invitent à repenser les modèles IAM traditionnels. L’Agent Name Service (ANS), nouveau standard ouvert inspiré du DNS, apporte une identité vérifiable aux agents pour sécuriser les échanges machine à machine. Reste à l’inscrire dans une architecture Agentic Zero Trust capable de gouverner leurs accès et leurs actions.
Les systèmes de gestion des accès en entreprise (les architectures IAM) ont été conçus pour deux situations bien précises. D’un côté, un humain qui se connecte. Il doit prouver son identité avec un mot de passe, parfois complété par une double vérification (authentification multifacteur, MFA). De l’autre, des comptes de service ou des clés d’API statiques taillées pour des charges de travail (« workloads ») hautement prévisibles.
Les agents d’IA autonomes n’entrent dans aucune de ces deux cases. Ces systèmes sont capables d’interpréter un objectif global, de planifier les étapes pour l’atteindre, d’invoquer des outils tiers via API. Ils peuvent ensuite interagir directement avec d’autres systèmes ou agents pour le compte de l’entreprise. Seulement voilà, cette autonomie brouille les repères de l’IAM traditionnel.
Comment dès lors attribuer une identité à un agent, vérifier qu’il est bien celui qu’il prétend être et lui accorder des droits en toute confiance ? Certes, des protocoles comme MCP ou Agent-to-Agent (A2A) organisent déjà les échanges entre les machines. Or, à proprement parler, ces protocoles n’ont jamais eu pour vocation de gérer l’identité.
Ce défi est d’autant plus pressant que l’adoption de l’IA générative change de nature. Selon le Forum économique mondial, 82 % des dirigeants prévoient en effet de déployer des agents d’IA dans les trois prochaines années. Pourtant, seuls 11 % des responsables technologiques interrogés par l’IBM Institute for Business Value estiment être prêts à en assurer la gouvernance à grande échelle. L’autonomie des agents progresse donc plus vite que les mécanismes censés les encadrer.
C’est précisément ce déficit de gouvernance que nous analysions dans notre livre blanc « Agents IA : le déficit de la gouvernance IAM ». Depuis, le paysage a évolué. La Linux Foundation a annoncé le lancement de l’Agent Name Service (ANS), un standard ouvert. Il applique aux agents IA les principes du DNS, l’annuaire qui identifie de façon fiable les sites sur Internet. Il leur attribue ainsi une identité vérifiable, découvrable et rattachée à une organisation.
L’ANS apporte ainsi aux solutions IAM un nouvel outil pour sécuriser l’identité des agents autonomes.
C’est une première étape indispensable avant de pouvoir gouverner leurs accès, appliquer les principes de sécurité du Zero Trust et mieux maîtriser les risques liés à l’IA agentique.
L’Agent Name Service (ANS) : une couche de confiance calquée sur le DNS
Face à ce vide protocolaire, la Linux Foundation a annoncé le 23 juin 2026 son intention de lancer l’Agent Name Service (ANS). Ce service d’annuaire destiné aux agents d’intelligence artificielle est développé avec le concours de grands acteurs de l’infrastructure Internet et de la cybersécurité. Citons, entre autres, Cloudflare, GoDaddy, Salesforce, Cisco et Infoblox. L’ANS, standard ouvert, applique à l’identification des agents d’IA les principes qui ont fait leurs preuves avec le DNS.
Pas de registre centralisé, pas de solution propriétaire entre les mains d’un seul géant.
Une organisation peut ainsi rattacher l’identité de ses agents à un domaine qu’elle contrôle (par exemple ans://v1.0.0.agent-finance.entreprise.com).
L’ANS fait bien plus que certifier une identité. Elle localise un agent, identifie son organisation et expose ses caractéristiques techniques.
Cette capacité répond au défi de sécurité de l’IA fantôme (« shadow AI »). Entendez par là l’apparition d’agents d’intelligence artificielle inconnus des équipes qui doivent pourtant les sécuriser. Identité, vérification et découverte constituent alors les trois briques nécessaires pour instaurer un climat de confiance.
Prouver une identité, garantir l’intégrité d’un historique, relier un agent à une organisation responsable… Techniquement, l’ANS transpose aux agents IA les mécanismes de confiance déjà utilisés pour sécuriser les échanges numériques. Il s’appuie pour cela sur plusieurs standards cryptographiques et protocoles existants :
- Vérification d’identité et délivrance : Chaque agent reçoit un nom versionné. Son certificat d’identité, en revanche, n’est délivré qu’une fois le domaine passé par les mêmes contrôles DNS et ACME qu’un site web pour obtenir un certificat TLS ordinaire. Le parcours d’émission est donc éprouvé, pas expérimental.
- Transparence : Les enregistrements, renouvellements et révocations sont consignés dans un journal immuable basé sur la technologie Merkle. Celle-ci empêche de réécrire l’historique d’un agent après coup.
- Vérification hors ligne : l’outil ans-verify valide instantanément la signature et l’intégrité du code d’un agent sans connexion active au registre global.
- Vérification de provenance : Les certificats d’identité signés facilitent la communication sécurisée de machine à machine (mTLS) entre les agents.
- Support des standards d’entreprise : L’ANS prend aussi en charge les identifiants décentralisés (DIDs) et les Legal Entity Identifiers (LEIs). Ce double support facilite l’intégration des systèmes d’identité existants dans un modèle de vérification unifié. Ce dernier relie ainsi l’entité logicielle à la personne morale qui en répond.
Détail qui parlera aux équipes techniques, l’implémentation de référence est un dépôt Go sous licence MIT. Celui-ci embarque toute la pile (registre, journalisation, vérificateur).
À nuancer tout de même : on parle d’une intention de lancement, à un stade encore précoce. Le DNS demeure, par conception, peu adapté pour porter des identités hautement sensibles, d’où le besoin de mécanismes complémentaires contre l’usurpation. Par ailleurs, l’ANS arrive sur un terrain déjà occupé par d’autres cadres.
Citons notamment AGNTCY, un projet porté par Cisco pour faciliter la découverte et l’interaction entre agents. Mentionnons également DNS-AI Discovery, une approche qui s’appuie sur les mécanismes du DNS pour permettre aux applications de trouver des agents IA disponibles. Une brique prometteuse, donc, mais à adopter en connaissance de cause, pas comme un standard déjà gravé dans le marbre.
L’ANS : une brique de confiance, pas une solution de gouvernance
Le mauvais réflexe serait de traiter l’ANS comme un système de contrôle d’accès. Ce n’est pas son rôle. L’ANS ne dit pas si un agent a le droit de lire une table SAP, et ne gère aucun processus d’approbation. Il répond à une seule question, strictement infrastructurelle : « puis-je prouver, de manière cryptographique, qui est cet agent et à qui il appartient ? »
Autrement dit, l’ANS prouve qui parle, jamais ce ne qu’on l’autorise à faire. Tout le reste (autorisations, revues d’accès, moindre privilège) se construit au-dessus, dans une véritable architecture de gouvernance. C’est pourquoi l’ANS doit se positionner comme une couche transversale d’infrastructure de confiance (« Trust Infrastructure ») qui alimente l’ensemble des modules de la gouvernance des identités et des accès (GIA).
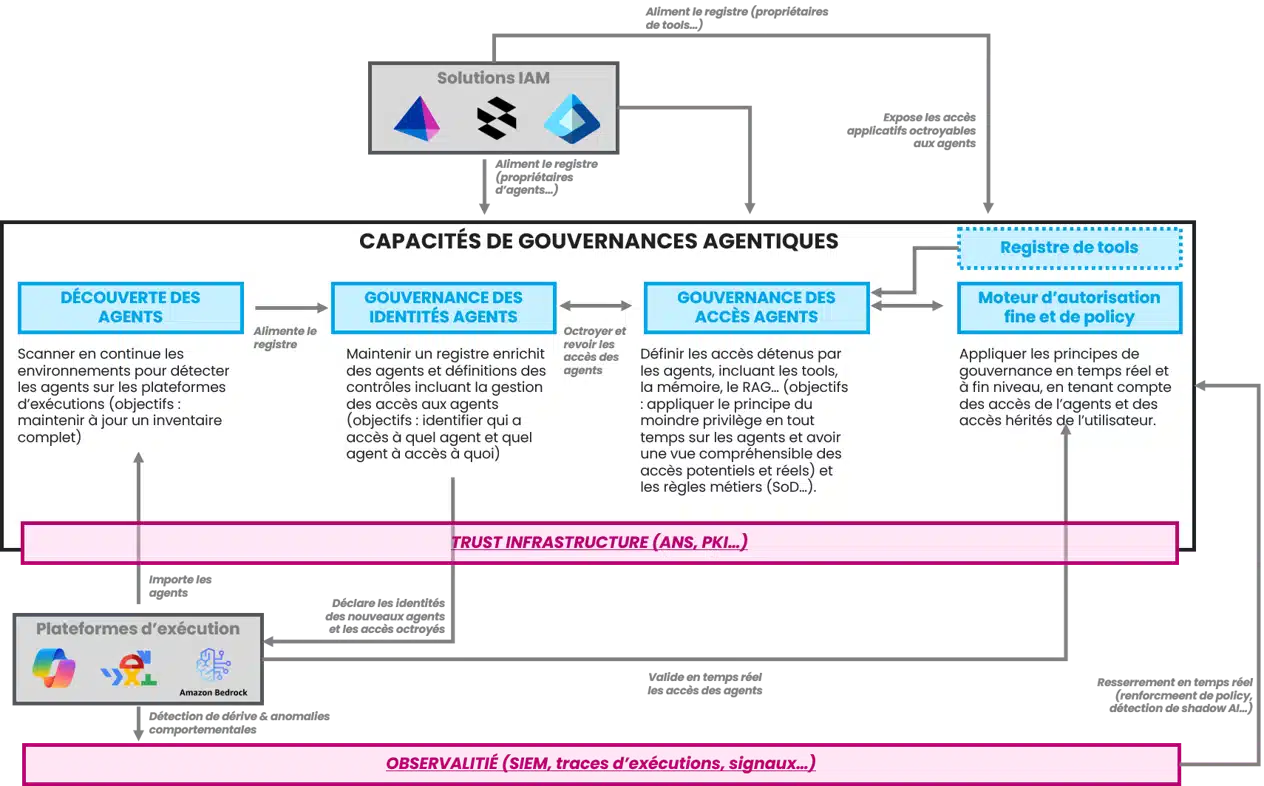
En amont, les solutions IAM déjà en place alimentent le registre (en tant que propriétaires des agents et des outils) et exposent aux agents les accès applicatifs octroyables. En aval, la gouvernance agentique s’articule autour de quatre capacités qui se passent le relai :
- Découverte des agents : scanner en continu les environnements pour détecter les agents présents sur les plateformes d’exécution.
- Gouvernance des identités agents : maintenir un registre enrichi des agents et de leurs contrôles, gestion des accès aux agents comprise.
- Gouvernance des accès agents : définir précisément les accès de chaque agent (outils, mémoire, RAG…).
Pour aller plus loin
Du moindre privilège au moindre agency
Le principe du moindre privilège est familier. Il ne donner à une identité que les accès strictement nécessaires. Mais appliqué à un agent, il ne suffit plus.
L’Open Worldwide Application Security Project (OWASP) a formalisé un concept complémentaire, le Least Agency, c’est-à-dire une autonomie excessive des agents IA. Il étend la restriction au-delà de l’accès. On contraint aussi ce que chaque outil peut faire, à quelle fréquence, et dans quel périmètre.
Un agent connecté à une base de données ne reçoit que des droits en lecture. Un outil d’envoi de courriel perd le droit de supprimer. Un appel API est borné aux opérations CRUD minimales.
C’est la même logique que la gouvernance des accès agents décrite ci-dessus, traduite au niveau de chaque outil.
Le framework Zero Trust for AI Agents publié par Anthropic en reprend le principe comme fondation de son modèle d’autorisation, confirmant que le moindre privilège seul ne couvre plus le périmètre de risque introduit par l’autonomie agentique.
- Engin d’autorisation fine et de policy : appliquer ces principes en temps réel (runtime) et au niveau le plus fin, en tenant compte à la fois des accès propres à l’agent et de ceux hérités de l’utilisateur pour lequel il agit. C’est aussi ici que s’ancre le policy-as-code : plutôt que d’éparpiller les règles d’autorisation dans la configuration de chaque application, on les exprime sous forme de code : versionné, testé, auditable, rejouable. Chaque règle relie explicitement le « qui » (l’identité prouvée en amont) au « quoi » (l’action demandée sur telle ressource), et toute modification laisse une trace. Une décision d’accès cesse alors d’être un réglage enfoui pour devenir un artefact gouvernable, revu comme n’importe quel autre morceau de code critique.
Un dernier fil traverse ces quatre capacités sans se confondre avec aucune : l’observabilité. Il s’agit de la capacité à observer, en continu, ce que les agents font réellement une fois en action (quelles ressources ils sollicitent, quelles actions ils exécutent, avec quelle fréquence).
Tout ce qui précède est préventif (qui existe, qui peut accéder à quoi, sous quelle règle). Mais un agent est non-déterministe. Ce qu’il fait réellement en production ne coïncide pas toujours avec ce qu’on avait prévu.
C’est là qu’intervient l’observabilité. Elle collecte en continu les traces d’exécution. Cela inclut les journaux des actions réalisées, qu’il s’agisse d’appels à des outils, d’échanges via MCP, un protocole permettant aux agents IA d’accéder à des ressources externes, ou des données effectivement consultées.
Elle centralise ensuite ces traces dans un SIEM, une plateforme de gestion des informations et des événements de sécurité chargée d’analyser ces événements.
Elle souligne l’écart entre accès potentiels et accès réels, et repère les enchaînements anormaux. Ces signaux alimentent ensuite la gouvernance : ajustement des règles de sécurité (« policies »), révocation d’une identité numérique ou déclenchement d’une revue humaine. Sans elle, la gouvernance reste déclarative. Avec elle, elle devient une boucle qui se corrige en temps réel.
Pour aller plus loin
Baseline, détection, réponse : le triptyque de l’observabilité agentique
Observer ne suffit pas. Encore faut-il savoir quoi chercher et quoi faire de ce qu’on trouve. Le framework Zero Trust for AI Agents d’Anthropic structure l’observabilité autour de trois étapes enchaînées.
D’abord, établir une baseline : documenter le comportement normal de chaque agent (fréquence d’appels, outils utilisés, volumes de données consultées) pour disposer d’un point de référence.
Ensuite, détecter les anomalies : tout écart par rapport à cette référence (tel un agent qui se met soudainement à utiliser d’autres outils), qui multiplie les requêtes ou qui accède à des données inhabituelles déclenche une alerte, même si aucune action isolée n’est suspecte en soi.
Enfin, répondre à la vitesse machine : révoquer des accès, isoler un agent, suspendre automatiquement une session avant qu’un opérateur humain ait le temps de repérer l’alerte.
Le test proposé est limpide : « Does this make the attack impossible, or just tedious? » Un contrôle qui repose sur la friction (« rate limit », port non-standard) ne résiste pas à un attaquant agentique dont la patience est infinie et le coût par tentative quasi nul. Seuls les contrôles qui suppriment une capacité plutôt que de la ralentir passent le test.
De l’ANS à l’Agentic Zero Trust
L’essor des agents autonomes redéfinit les frontières de la productivité d’entreprise. Mais l’autonomie sans contrôle engendre un risque systémique que les infrastructures de sécurité classiques ne savent pas contenir. En proposant un protocole d’identité standardisé, décentralisé et sécurisé à l’échelle d’Internet, l’ANS marque un vrai tournant.
Reste que l’identité n’est que le point de départ. Prouver qui est un agent ne dit rien de ce qu’il devrait avoir le droit de faire. Et c’est précisément le principe fondateur du Zero Trust : ne jamais accorder de confiance par défaut, vérifier en permanence.
Décliné aux agents, cette Zero Trust Architecture (ZTA) suppose d’intégrer la brique d’identité au sein d’une architecture globale de gouvernance des identités et des accès. Cette dernière doit être capable d’évaluer, de surveiller et de restreindre les actions des agents en temps réel.
C’est tout l’enjeu de l’Agentic Zero Trust : le moment où « légitime par défaut » cesse d’être une option. Nous avons traité ce sujet dans l’article « Agentic Zero Trust : organiser la confiance autour des agents IA ».
Mais concevoir cette architecture soulève une question qu’on ne peut pas laisser à la seule technique. Qui décide de ce qu’un agent a le droit de faire ? Car cette décision relève du métier.
La cybersécurité outille, contrôle et applique. La donnée structure, qualifie et trace les usages. Mais c’est le métier qui tranche sur la légitimité d’un accès. Lui seul connaît la valeur et la sensibilité des données et ressources auxquelles l’agent accède.
L’agentique rapproche ainsi cybersécurité, data et métiers autour d’une même table de décision, dans une nouvelle façon de travailler.
Auteur
-
Marcellin Nachin
Leader Cybersécurité